Sistemas web
SignMed
Un paciente sordo en una consulta médica depende de que haya intérprete. SignMed ataca ese momento: el navegador captura los puntos de la mano, el cuerpo y la cara con MediaPipe, y un modelo CNN+LSTM clasifica la seña en tiempo real, con práctica guiada y exámenes para aprender el vocabulario clínico.
El problema
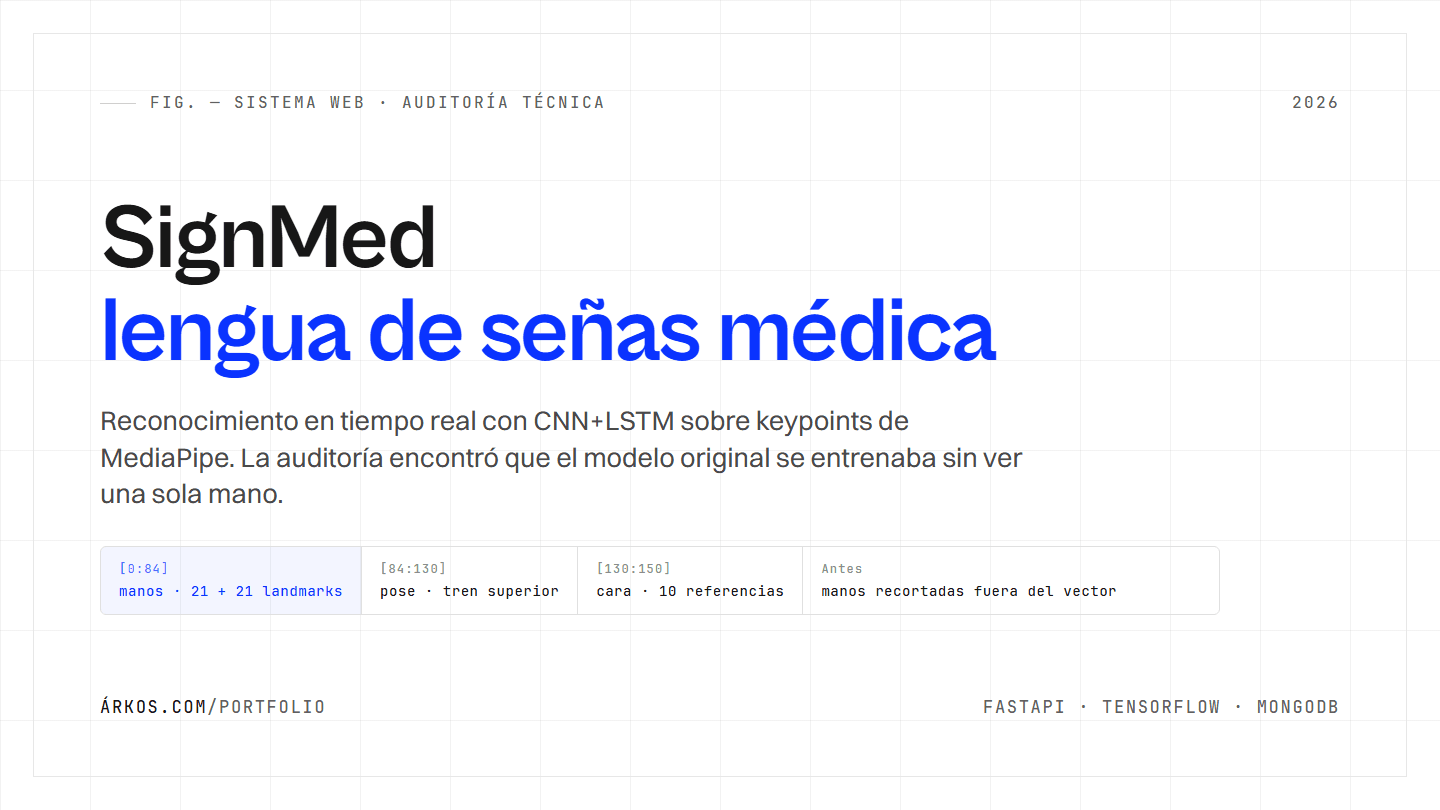
Recibí el proyecto funcionando y con una métrica que se veía bien: 0,80 de exactitud. Antes de construir encima, audité el pipeline. El vector de características se armaba con pose, cara y manos en ese orden y luego se recortaba a 150 valores; pose y cara ya sumaban 160. Las manos, que iban al final, quedaban siempre fuera del recorte. Un modelo de lengua de señas se había entrenado sin ver una sola mano.
La decisión / el criterio
Lo verifiqué antes de afirmarlo, porque una acusación así no se sostiene con una lectura del código. Comparé las coordenadas del bloque sospechoso contra las muñecas y la nariz de la pose: caían sobre la nariz. Medí cuánto se movía cada bloque a lo largo de la secuencia: el de pose siete veces más que el otro, que apenas se movía, como una cara y no como unas manos gesticulando. Recién con esa evidencia reescribí el layout de features y lo dejé en un solo archivo compartido por el grabador y el navegador, con las manos primero y con espacio garantizado.
— Rodrigo Torres, Árkos
Qué construimos
API en FastAPI con autenticación por roles y MongoDB, separada en endpoints que solo orquestan, servicios con la lógica y una capa de datos aislada; frontend en Next.js que captura los landmarks en el navegador; y suite de pruebas con CI en cada push. En el camino aparecieron dos fallos más: el entrenamiento no normalizaba las features pero la inferencia sí, así que el modelo veía en producción una distribución que nunca había visto; y una clase del catálogo era una errata en plural de otra, con dos muestras, que llegó al modelo publicado sin una sola muestra de prueba.
El resultado
El hallazgo incómodo es que el dataset actual no se puede arreglar reentrenando: las grabaciones nunca contuvieron las manos, la información no está ahí, y hay que volver a grabar con el grabador corregido. Así que la auditoría dice por escrito que el 0,80 publicado no mide reconocimiento de señas, y explica además por qué la partición aleatoria por fila infla ese número. El sistema queda desplegable y demostrable de punta a punta, con el pipeline corregido y el camino de reentrenamiento documentado. Publicar que la métrica de tu propio modelo no vale cuesta, pero es la única versión que sirve para decidir.
Vistazo